La oss ikke frede gamlemåten ved å bare granske feilene til KI
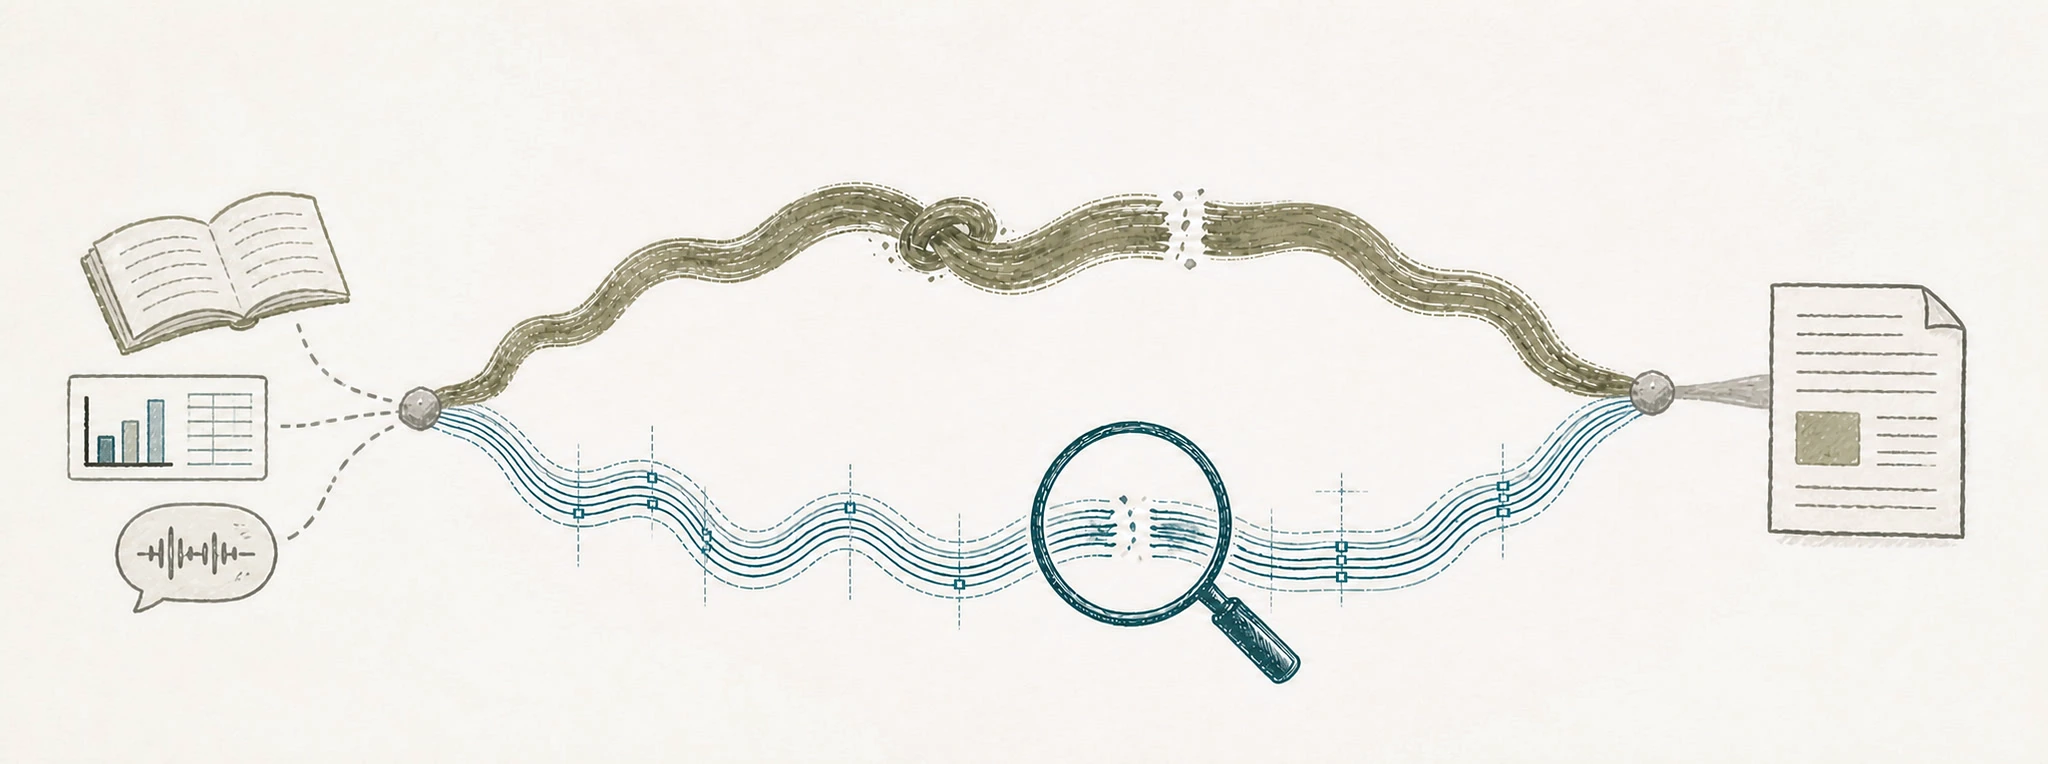
Å telle maskinens feil uten å sammenligne med vår egen arbeidsflyt gir fine tabloide overskrifter, men forteller oss lite om hvilken metode som fungerer best.
I november 2025 satte jeg meg ned for å svare Jill Walker Rettberg. Hun hadde inntatt et tydelig standpunkt i Aftenposten mot å bruke språkmodeller i kunnskapsarbeid, og jeg hamret ned et svar for å vise hvorfor jeg mente det var feil medisin. Jeg ga det tittelen «Nå er det nok. Stopp bruken av menneskelig intelligens i kunnskapsarbeid?», fikk et høflig svar fra Aftenposten om at de ikke hadde plass denne gangen, og lot det deretter gå i glemmeboken - inntil nylig!
Jeg tenker nemlig mye på hvordan vi snakker om og håndterer dette med at KI gjør feil, og jeg synes måten det diskuteres på i media - og forsåvidt også på de aller fleste andre arenaer, for å være helt ærlig! - er lite konstruktiv. Jeg ser verdien av å øke og opprettholde høy bevissthet rundt dette, men vi har også et ansvar for at vi alle blir utstyrt med god dømmekraft og kan ta velinformerte valg når det gjelder bruk av KI både på jobb og hjemme, og ikke minst i institusjonene som sørger for at landet vårt går rundt.
Det er ikke akkurat noe nytt at KI gjør feil. Tidlig i 2025 trakk Tromsø kommune kunnskapsgrunnlaget i en sak om skolestruktur etter at uverifisert bruk av KI førte til at dokumentet viste til kilder som rett og slett ikke fantes. I oktober samme år publiserte og trakk NTB et sammendrag av Telenors sikkerhetsrapport der budskapet var sterkt forvrengt, fem direkte sitater var ren fantasi og direktøren som ble sitert ikke eksisterte. Og da Alver kommune i mai 2026 la fram en utredning med rundt tretti forskningsreferanser der i alle fall tre viste seg å være rent oppspinn, begynte et tilbakevendende mønster å bli tydelig: modellene sliter med å holde styr på kilder og hvem som faktisk har sagt hva.
Da jeg nylig hentet fram og leste det gamle, upubliserte svaret mitt, syntes jeg at hovedargumentet mitt fortsatt er godt. Det finnes ingen naturlov som sier at systemer bygget på sannsynlighet ikke kan bli pålitelige nok til å være beviselig nyttige. Akkurat dette opplever jeg at mange samfunnsdebattanter fra akademiske miljøer har en tendens til å glemme. At språkmodeller i bunn og grunn «bare» predikerer det neste mest sannsynlige ordet, eller at de ikke har noe sannhetsbegrep, trenger rett og slett ikke henge sammen med hva de kan brukes til, eller hvor mye verdi de kan skape i praksis.
La oss i et øyeblikk underholde forestillingen om at det å diskutere denne typen argumenter egentlig tar oss noen vei. I så fall er det interessant å kverulere på påstanden om at modellene predikerer det neste mest sannsynlige ordet, som strengt tatt er korrekt, men som nesten alltid brukes i betydningen at de velger det neste mest sannsynlige ordet, uansett. Sannheten er at de trekker fra en distribusjon av sannsynligheter for ulike “biter av ord”, såkalte tokens. Denne distribusjonen er i tillegg betinget på et enormt kontekstvindu der hvert eneste ord som er skrevet av deg, og skrevet eller “tenkt” av modellen, er med på å beregne sannsynligheten for det neste modellen skal skrive eller “tenke”. Det er nettopp derfor modellene er i stand til å gå mange ulike veier med svarene sine.
Ble du nå klokere på om KI kan brukes i utførelsen av den ene eller den andre typen oppgaver? Nei, ikke jeg heller.
Poenget er at denne typen resonnementer er ganske ubrukelige når det gjelder å vurdere hva vi kan eller ikke kan bruke KI til. Vi måler nemlig ikke kvaliteten på utfallet av oppgavene vi løser ut fra den interne mekanismen som genererer ordene, eller ut fra om vi som mennesker «praktiserer et sannhetsbegrep» i utførelsen – hva nå enn det måtte innebære i praksis. Vi vurderer resultatet og nytten. Vi slutter heller ikke å bruke værmeldingen bare fordi den bommer på skydekket eller nedbøren iblant. Vi bruker den med fornuft og tar de nødvendige forholdsreglene, godt hjulpet av grensesnitt som er laget for de beslutningene vi faktisk skal ta.
Vi gjør ikke de samme feilene
Men jeg var kanskje litt vel fremoverlent i bukseselene med premisset jeg la til grunn da jeg skrev mitt svar i 2025: at mennesker feiler oftere og med verre utfall enn maskinene. Den slutningen har jeg strengt tatt ikke bevis for, og den overser ikke minst en viktig ting: Vi tabber oss stort sett ikke ut på den samme måten. Jeg tenkte kanskje den gangen at en litt tabloid motpåstand ville øke sannsynligheten for at Aftenposten ville publisere svaret mitt – og det kan jo hende at den gjorde det, bare ikke nok!
Fiktive direktører og oppdiktede forskningsreferanser er rett og slett ikke feil vi normalt forventer fra en redelig kunnskapsarbeider som oppsummerer en tekst. Vi gjør til gjengjeld en hel del andre feil som språkmodellene uhyre sjelden gjør, selv om vi utmerket godt deler evnen til å utelate viktige poenger, feilsitere og vri på meningen. Feil er ikke én enkelt ting, enten de gjøres av KI eller mennesker.
Vi kan ikke bare registrere hver gang teknologien gjør en feil. Vi må sette den nye, KI-støttede arbeidsflyten opp mot den gamle måten å gjøre ting på. Og med «arbeidsflyt» mener jeg da noe mer enn å klippe og lime tekst inn i en hvilken som helst chat i nettleseren.
Så må vi stille oss selv noen konkrete spørsmål:
- Hva slags feil gjør vi når vi løser oppgaven selv, og hva slags feil oppstår når vi bruker KI?
- Hvor alvorlige er konsekvensene av de ulike typene feil når de inntreffer?
- Hvor lette er de å oppdage og rette opp underveis i arbeidet?
- Overlapper feilene våre med modellens, eller bommer vi på delvis forskjellige ting?
- Hvordan kan vi lage en prosess og et grensesnitt mellom menneske og maskin som sannsynliggjør høy kvalitet på resultatene vi er opptatt av?
- Og når vi legger sammen alt, inkludert tiden vi bruker på å kvalitetssikre og rette opp, hvordan blir den totale kvaliteten og tidsbruken?
Akkurat overlappet er interessant. En studie i Nature Medicine fra 2024 så på KI-støttede røntgenrapporter. I tilfellene der enten originalrapporten eller KI-rapporten hadde minst én klinisk signifikant feil, var feilene forskjellige i 59,7 til 72,7 prosent av dem: De fantes bare i én av rapportene. Medisin er åpenbart noe annet enn saksbehandling, men funnet illustrerer hvorfor overlapp hører hjemme i regnestykket.
Å sammenligne to måter å jobbe på
Rettberg har et skarpt poeng når hun etterlyser en grundigere analyse av hvordan modellene feiler. Men spesielt i miljøer som er drillet i å kreve metodisk sammenligning for å vurdere om noe virker, må vi tørre å rette den samme linsen mot vår egen, etablerte måte å jobbe på. Når et forsøk med KI slår feil, mangler det nesten alltid én ting i regnestykket, og det er hvordan den etablerte prosessen fungerer. At den nye metoden sviktet i et konkret tilfelle, forteller oss i bunn og grunn lite om hvordan den KI-støttede flyten presterer når vi måler den opp mot det alternativet vi uansett lener oss på for å få jobben gjort.
Dette betyr ikke at vi trenger å gjøre hvert eneste KI-forsøk til et tungt forskningsprosjekt. Innsatsen må rett og slett henge sammen med hva det koster å ta feil. Er oppgaven ufarlig og ukomplisert, holder det kanskje med noen stikkprøver iblant. Er kompleksiteten høyere og det står mer på spill, kan vi rigge en skikkelig sammenligning: la fagfolk løse reelle oppgaver med og uten KI, og la kolleger vurdere kvaliteten uten å vite hvordan jobben ble gjort.
Uansett metode tester vi egentlig akkurat det samme: hvordan folk, verktøy og rutiner faktisk fungerer sammen.
Samtidig må vi være ærlige om at kombinasjonen av oss og en modell ikke automatisk hever kvaliteten, i hvert fall ikke med én gang. I starten kan den nye prosessen fort levere dårligere resultater enn den gamle måten å gjøre ting på, fordi en travel gjennomlesning ikke fanger opp de velskrevne, troverdige feilene som modellene innimellom produserer.
Å vurdere utkast er en egen ferdighet
Det er egentlig ikke så rart. De fleste av oss som tar i bruk KI i dag er trent til å utføre arbeidet fra bunnen av selv, ikke til å lese andres troverdige utkast for å fange opp subtile utelatelser og gi presise tilbakemeldinger. Dette minner langt mer om å lede eller veilede andres arbeid enn å utføre kjerneoppgaven på egenhånd, og det å være en dyktig saksbehandler gjør deg ikke automatisk til en god redaktør.
Kanskje dette er noe av grunnen til at en større andel ledere virker å være mer entusiastiske og komfortable med å bruke KI i arbeidet sitt, fordi det har mer til felles med måten de allerede er vant til å jobbe på? Tenk litt over det før du beskylder ledere for å “sluke KI-hypen” rått; det kan hende de rett og slett er bedre til å bruke KI enn deg!
At vi gjør feil når vi skal lære oss nye måter å jobbe på er verken overraskende eller et bevis på at KI ikke fungerer for oppgaven. Læringskurven er en god grunn til å trene folk og forbedre arbeidsflyten underveis, men den er selvfølgelig ikke en evig fluktluke som vi kan bruke til å unnskylde KI-en. Viser det seg at den nye arbeidsflyten fremdeles leverer dårligere kvalitet etter at vi har fått rimelig tid til å lære og justere, så endrer vi prosessen, eller så slutter vi å bruke KI til akkurat den oppgaven.
Det går også en grense for hva en direkte måling av kvalitet her og nå kan fortelle oss. Et godt resultat på en konkret oppgave i dag gir oss ikke svaret på hva den nye måten å jobbe på gjør med dybdeforståelsen vår over tid, og dette forblir en reell risiko vi må ta på alvor. Det kan være stor forskjell på kortsiktige og langsiktige effekter av teknologi, men vi må klare å skille på når vi snakker om hva.
At en KI-støttet prosess svikter i et enkelt tilfelle, betyr i alle fall ikke at den gamle prosessen er generelt bedre og tryggere. Hvis den nye arbeidsflyten taper når vi vurderer metodene opp mot hverandre på en bestemt oppgave, legger vi den bort for akkurat det formålet. Vinner den derimot sammenligningen og hever kvaliteten, kan vi ikke tviholde på at den gamle måten å gjøre ting på er det tryggeste valget bare fordi vi er så godt vant til hvordan den svikter.